
Trong một bài tập Marketing Data Analytics, nhóm tôi làm việc với bộ dữ liệu mô phỏng gồm 15.000 giao dịch và 19 biến. Đây không phải dữ liệu giao dịch chính thức của Hasaki, không phải dự án do doanh nghiệp thuê và không phản ánh kết quả kinh doanh thật. Tôi phụ trách phần hồi quy cho nhóm khách hàng thường/VIP và tham gia xây dựng dashboard; bài viết này tập trung vào mô hình của nhóm khách hàng Normal.
Khi chỉ dùng số lượng sản phẩm để giải thích tổng tiền, R² đạt 22,9%. Khi thêm đơn giá, danh mục, tên sản phẩm, thành phố và phân khúc, R² tăng lên 88,7%. Câu trả lời ngắn là một biến đã bỏ sót phần thông tin quan trọng, đặc biệt là đơn giá. Nhưng bài học đáng giá hơn là: R² cao chưa đủ chứng minh mô hình đúng, dự báo tốt hay có ý nghĩa kinh doanh.
Tóm tắt chính
• R² 22,9% nghĩa là mô hình đơn biến giải thích khoảng 22,9% biến thiên của Total Amount trong mẫu hồi quy, không phải “dự báo đúng 22,9%”.
• Hai bảng hồi quy dùng 14.111 quan sát thuộc nhóm Normal; con số 15.000 mô tả toàn bộ bộ dữ liệu mô phỏng.
• Unit Price và Quantity nổi bật trong mô hình đa biến, nhưng Total Amount lại được cấu thành từ hai biến này. Vì vậy R² cao là điều có thể dự đoán trước.
• Kết quả hiện tại là in-sample. Chưa có bằng chứng trong báo cáo cho thấy mô hình ổn định trên dữ liệu mới.
• Trước khi dùng hồi quy cho quyết định marketing, cần xác định thời điểm dự báo, mã hóa đúng biến phân loại và đánh giá residual, outlier, VIF lẫn dữ liệu ngoài mẫu.
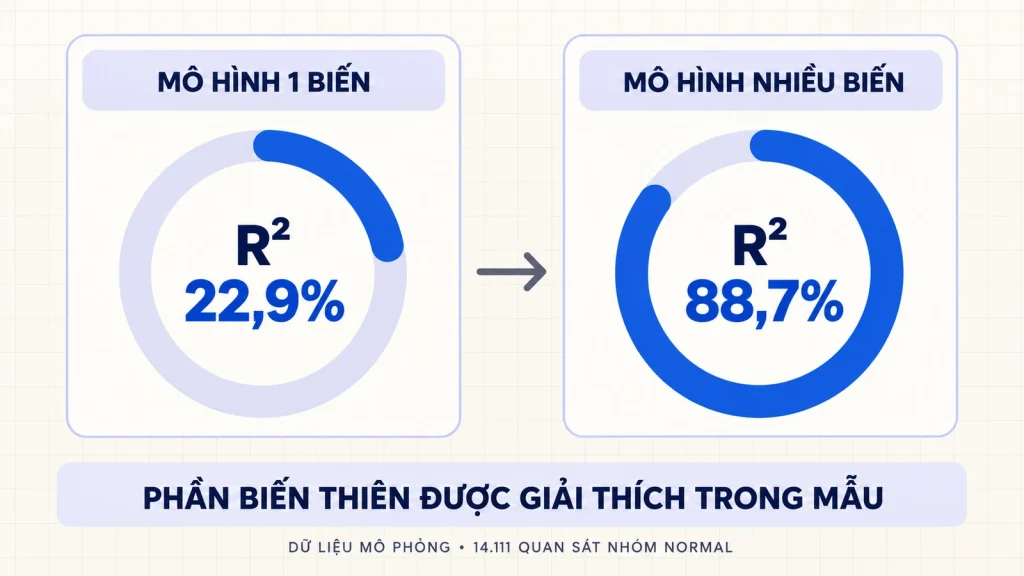
So sánh R² 22,9% của mô hình một biến và 88,7% của mô hình nhiều biến
R² là gì nếu giải thích bằng ngôn ngữ marketing?
R², hay hệ số xác định, cho biết mô hình giải thích được bao nhiêu phần biến thiên của biến phụ thuộc so với một mốc chỉ dự đoán bằng giá trị trung bình. Tài liệu R² của scikit-learn mô tả R² tốt nhất là 1,0; mô hình luôn đoán trung bình có R² bằng 0 trong trường hợp thông thường, và R² thậm chí có thể âm khi mô hình tệ hơn mốc đó.
R² đo phần biến thiên mà mô hình giải thích được
Nếu đang phân tích Total Amount, R² 0,229 có thể đọc là: trong mẫu đang dùng, mô hình tuyến tính với Quantity giải thích khoảng 22,9% biến thiên của tổng tiền quanh giá trị trung bình. Phần còn lại nằm trong residual, tức chênh lệch giữa giá trị quan sát và giá trị mô hình ước lượng.
Cách đọc này có phạm vi rất cụ thể. Nó không nói rằng 22,9% đơn hàng được dự đoán đúng, cũng không nói sai số của từng đơn hàng là 77,1%. Muốn biết độ lệch dự báo theo đơn vị tiền, cần xem thêm MAE, RMSE hoặc sai số chuẩn ước lượng, tùy mục tiêu.
R² cao không đồng nghĩa mô hình đúng, hữu ích hoặc có quan hệ nhân quả
Một R² cao vẫn có thể đi cùng mô hình sai dạng, biến bị rò rỉ từ kết quả, ngoại lệ có ảnh hưởng mạnh hoặc hiệu năng kém trên dữ liệu mới. Ngược lại, trong những bài toán hành vi con người có nhiều nhiễu, R² thấp hơn vẫn có thể giúp trả lời một câu hỏi hẹp nếu thiết kế nghiên cứu và cách diễn giải phù hợp.
R² cũng không chứng minh Quantity hay Unit Price “gây ra” thay đổi hành vi mua. Hồi quy trong bài chỉ mô tả mối liên hệ trong dữ liệu mô phỏng. Muốn nói về tác động nhân quả cần thiết kế thí nghiệm, dữ liệu theo thời gian hoặc chiến lược nhận diện phù hợp hơn.
Khi thêm biến, vì sao cần nhìn cả Adjusted R²?
R² thông thường không giảm khi thêm biến, kể cả khi biến mới đóng góp rất ít. Adjusted R² điều chỉnh theo số biến và số quan sát, vì vậy hữu ích hơn khi so sánh các mô hình có độ phức tạp khác nhau.
Trong case này, R² và Adjusted R² đều được làm tròn ở 0,887 trong mô hình đa biến. Khoảng cách rất nhỏ là tín hiệu đáng ghi nhận, nhưng chưa phải bằng chứng chống overfitting. Mẫu lớn 14.111 quan sát khiến mức phạt cho sáu biến tương đối nhỏ; đánh giá trên tập hold-out hoặc cross-validation vẫn cần thiết.
Bối cảnh dữ liệu của bài phân tích
Bộ dữ liệu mô phỏng 15.000 giao dịch và 19 biến
Bộ dữ liệu gốc có 15.000 dòng và 19 cột, không ghi nhận dòng trùng. Rating thiếu khoảng 29,8% trong riêng cột đó; khi tính trên toàn bộ ma trận 19 cột, số ô thiếu chiếm khoảng 1,57%. Hai tỷ lệ dùng hai mẫu số khác nhau nên không mâu thuẫn.
Tuy nhiên, hai bảng hồi quy đang phân tích không dùng toàn bộ 15.000 dòng. Tổng bậc tự do trong ANOVA là 14.110, tương ứng 14.111 quan sát thuộc nhóm Normal. Việc tách rõ hai phạm vi giúp tránh một lỗi phổ biến: lấy quy mô toàn bộ dữ liệu làm quy mô của mọi mô hình con.
Biến phụ thuộc là tổng tiền và các biến giải thích được chọn
Biến phụ thuộc là Total Amount. Mô hình thứ nhất chỉ dùng Quantity. Mô hình thứ hai thêm Unit Price, Category, Product Name, City và Customer Segment. Báo cáo cũng kiểm tra Model Summary, ANOVA, hệ số, residual và VIF.
Một lưu ý biên tập quan trọng: Category, Product Name, City và Customer Segment là biến phân loại. Nếu chúng chỉ được gán các số nguyên rồi đưa thẳng vào hồi quy, hệ số sẽ ngầm coi khoảng cách giữa các mã là có ý nghĩa. Tài liệu MathWorks về hồi quy với biến phân loại minh họa cách đưa biến nhóm vào bằng indicator/dummy và xác định nhóm tham chiếu. Khi chưa có data dictionary và coding scheme, không nên diễn giải “tăng một đơn vị City” hay “tăng một đơn vị Product Name” như một thay đổi thực tế.
Vì sao phải ghi rõ đây không phải dữ liệu kinh doanh thật của Hasaki?
Nhãn “dữ liệu mô phỏng” bảo vệ tính trung thực của portfolio. Nó cho người đọc biết các con số được dùng để luyện quy trình phân tích, không phải để công bố tình hình kinh doanh của một thương hiệu. Cách ghi này cũng giúp nhà tuyển dụng đánh giá đúng năng lực: tôi có thể xây dựng và diễn giải mô hình, nhưng không nhận một nguồn dữ liệu hoặc quan hệ khách hàng mà dự án không có.
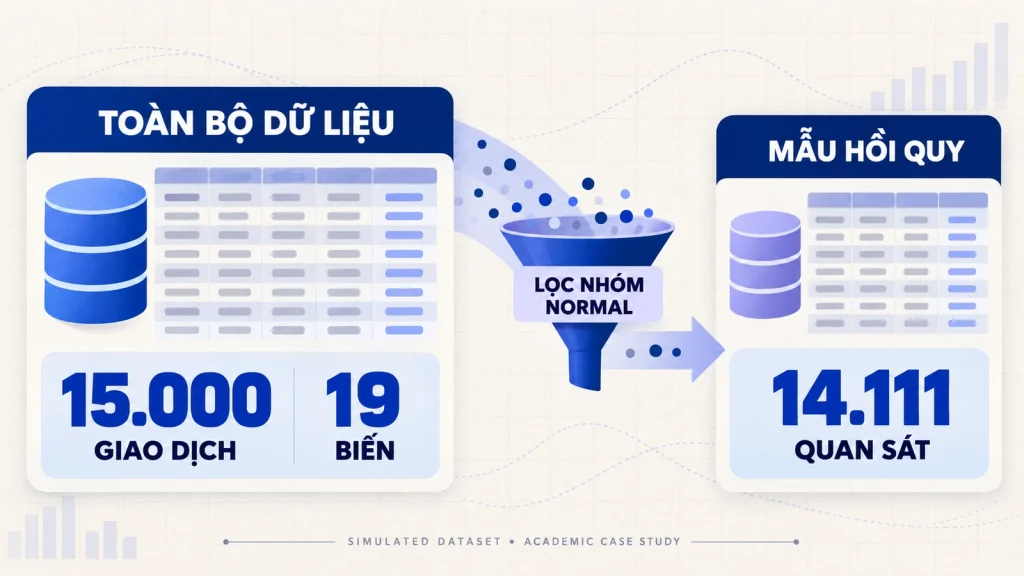
Bộ dữ liệu mô phỏng 15.000 dòng được lọc còn 14.111 quan sát nhóm Normal cho hồi quy
Mô hình 1: Số lượng giải thích được 22,9% biến thiên của tổng tiền
Phương trình hồi quy đơn biến
Phương trình được báo cáo là:
Total Amount = 129.539,531 + 300.724,007 × Quantity
Mô hình có R² = 0,229; Adjusted R² = 0,229; F = 4.197,310; p < 0,001. Sai số chuẩn ước lượng là 445.396,859 theo đơn vị tiền tệ trong dữ liệu. F-test cho thấy mô hình có Quantity phù hợp với dữ liệu hơn mô hình chỉ có hằng số, dưới các giả định của hồi quy; nó không cho biết mọi dự báo đều gần giá trị thật.
Hệ số chặn 129.539,531 là giá trị ước lượng khi Quantity bằng 0. Nếu dữ liệu chỉ gồm giao dịch có ít nhất một sản phẩm, điểm này nằm ngoài miền quan sát có ý nghĩa kinh doanh và không nên được kể như “đơn hàng 0 sản phẩm vẫn tạo ra 129.539 đồng”.
Diễn giải hệ số của Quantity mà không biến tương quan thành nhân quả
Trong phạm vi mô hình, mỗi khi Quantity tăng thêm một đơn vị, Total Amount ước lượng tăng trung bình khoảng 300.724 đơn vị tiền tệ. Đây là mối liên hệ có điều kiện trong dữ liệu, không phải kết luận rằng buộc khách mua thêm một sản phẩm chắc chắn tạo đúng mức tăng đó.
Hệ số còn trộn lẫn nhiều mức giá. Một sản phẩm phổ thông và một sản phẩm cao cấp đều làm Quantity tăng một đơn vị, nhưng ảnh hưởng đến Total Amount rất khác. Vì Unit Price chưa có trong mô hình, hệ số Quantity phải gánh cả sự khác biệt giá và cơ cấu sản phẩm.
77,1% còn lại gợi ý điều gì về đơn giá và cấu trúc giỏ hàng?
Phần 77,1% chưa được mô hình đơn biến giải thích gợi ý rằng chỉ đếm số lượng là chưa đủ. Hai giỏ cùng ba sản phẩm có thể chênh nhau lớn nếu đơn giá, danh mục hoặc tổ hợp sản phẩm khác nhau.
Đây là lúc một người phân tích nên đặt câu hỏi về omitted variable thay vì vội đánh giá mô hình “tệ”. Với tổng tiền, Unit Price là biến cần kiểm tra đầu tiên. Những biến khác như Category có thể mô tả cấu trúc giỏ, nhưng phải được mã hóa đúng và đánh giá phần đóng góp tăng thêm.
Mô hình 2: Điều gì thay đổi khi bổ sung nhiều biến?
Các biến được thêm gồm Unit Price, Category, Product Name, City và Segment
Mô hình thứ hai dùng sáu biến: Quantity, Unit Price, Category, Product Name, City và Customer Segment. Việc thêm biến mở rộng câu hỏi từ “số lượng liên hệ với tổng tiền ra sao” thành “khi xem xét đồng thời giá và một số thuộc tính giao dịch, phần biến thiên được giải thích thay đổi thế nào”.
Nhưng số lượng biến nhiều hơn không tự động làm mô hình có giá trị hơn. Cần xem từng hệ số, cách mã hóa, ΔR² khi thêm từng nhóm biến và hiệu năng trên dữ liệu chưa dùng để ước lượng.
R² và Adjusted R² cùng đạt khoảng 88,7%
Mô hình đa biến có R = 0,942; R² = 0,887; Adjusted R² = 0,887; F = 18.368,911; p < 0,001. Sai số chuẩn ước lượng giảm từ khoảng 445.397 xuống 170.916 theo đơn vị tiền tệ trong dữ liệu. Trong mẫu đang phân tích, mô hình giải thích khoảng 88,7% biến thiên của Total Amount.
Con số này mô tả độ phù hợp trong mẫu, không phải tỷ lệ giao dịch dự báo đúng. Báo cáo chưa trình bày một tập test tách biệt, MAE/RMSE ngoài mẫu hoặc kết quả cross-validation, vì vậy chưa thể tuyên bố hiệu năng dự báo trên dữ liệu mới.
H3 Đơn giá và số lượng là hai biến nổi bật trong mô hình
| Biến | Beta chuẩn hóa | p-value báo cáo | Cách đọc thận trọng |
|---|---|---|---|
| Unit Price | 0,818 | < 0,001 | Liên hệ dương nổi bật nhất trong đặc tả hiện tại |
| Quantity | 0,569 | < 0,001 | Liên hệ dương nổi bật thứ hai |
| Category | 0,031 | < 0,001 | Hiệu ứng nhỏ; cần biết coding scheme trước khi diễn giải |
| Product Name | -0,004 | 0,186 | Chưa có bằng chứng thống kê rõ trong đặc tả này |
| City | 0,002 | 0,461 | Chưa có bằng chứng thống kê rõ trong đặc tả này |
| Customer Segment | 0,002 | 0,400 | Chưa có bằng chứng thống kê rõ trong đặc tả này |
Beta chuẩn hóa giúp so sánh mức liên hệ tương đối trong cùng mô hình, nhưng không phải ROI, mức tăng doanh thu hay tác động nhân quả. Với 14.111 quan sát, một hệ số nhỏ vẫn có thể đạt p-value thấp. Vì vậy Category có ý nghĩa thống kê không đồng nghĩa đây là đòn bẩy kinh doanh lớn.
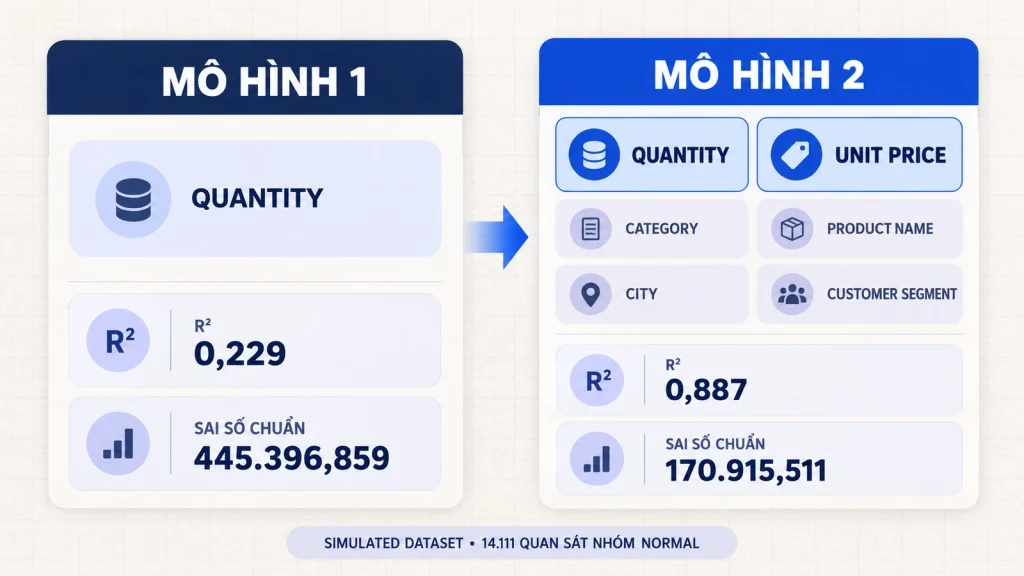
Sơ đồ so sánh biến và chỉ số của mô hình hồi quy đơn biến và đa biến
Vì sao R² tăng mạnh từ 22,9% lên 88,7%?
Một đơn hàng cùng số lượng có thể có mức giá rất khác
Quantity chỉ đếm số sản phẩm, không biết mỗi sản phẩm trị giá bao nhiêu. Khi Unit Price được thêm, mô hình nhận được phần thông tin trực tiếp về mức giá. Điều này làm giảm một lượng lớn biến thiên trước đó nằm trong residual.
Để xác định chính xác biến nào tạo ra bao nhiêu phần tăng R², cần xây mô hình lồng nhau: Quantity; Quantity + Unit Price; sau đó lần lượt thêm Category và các biến phân loại. Báo cáo hiện so sánh hai đầu mút nên cho thấy mức thay đổi tổng, chưa tách riêng ΔR² của từng bước.
Total Amount vốn có quan hệ cấu thành với Quantity và Unit Price
Báo cáo xác nhận các giao dịch được kiểm tra tuân theo công thức Total Amount = Quantity × Unit Price. Đây là chi tiết quyết định cách diễn giải. Khi đưa hai thành phần cấu thành trực tiếp biến đích vào mô hình, R² cao không còn là phát hiện bất ngờ về hành vi khách hàng; mô hình đang tái dựng một quan hệ kế toán đã biết.
Đặc tả tuyến tính hiện tại cộng Quantity và Unit Price thay vì dùng tích tương tác của chúng, nên R² không đạt 1,0. Tuy vậy, hai biến vẫn chứa phần lớn thông tin tạo nên Total Amount. Nếu mục tiêu chỉ là tính tổng tiền sau khi đã biết số lượng và đơn giá, không cần hồi quy; phép nhân cho kết quả trực tiếp và dễ kiểm tra hơn.
R² cao trong mẫu dữ liệu này là hợp lý nhưng không phải bằng chứng nhân quả
R² 88,7% hợp lý về mặt cấu trúc, nhưng không chứng minh tăng giá hay ép mua nhiều hơn sẽ tạo ra hiệu quả marketing mong muốn. Thay đổi giá có thể làm thay đổi nhu cầu; Quantity và Unit Price có thể đồng thời chịu ảnh hưởng của khuyến mãi, danh mục, mùa vụ hoặc khả năng chi trả.
Giá trị của case không nằm ở việc “tìm ra” công thức tổng tiền. Giá trị nằm ở bài học kiểm tra target trước khi xây mô hình: biến nào đã có sẵn tại thời điểm ra quyết định, biến nào là thành phần của kết quả và mô hình có đang trả lời đúng câu hỏi kinh doanh hay không.
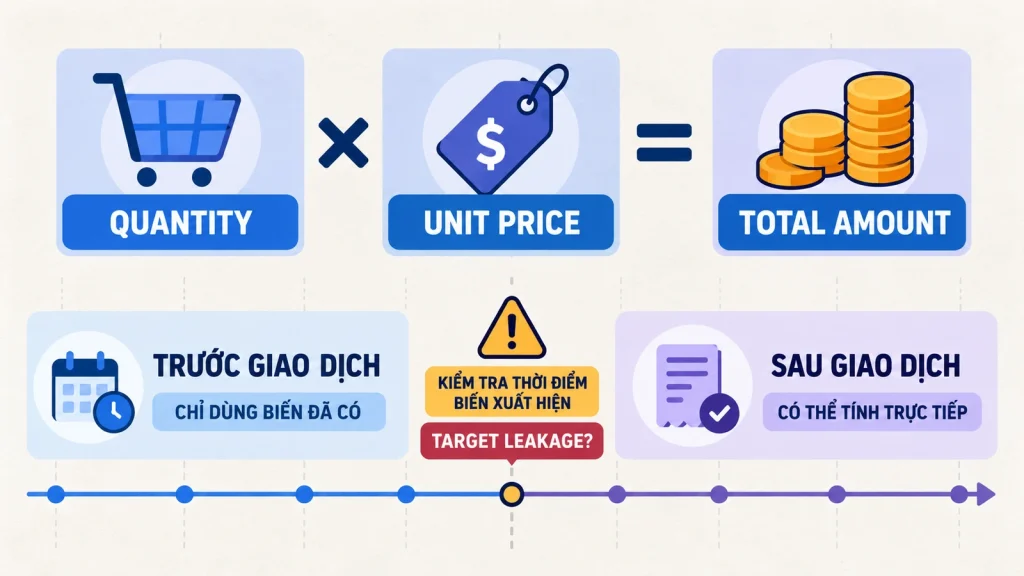
Total Amount được cấu thành từ Quantity nhân Unit Price và cảnh báo data leakage theo thời điểm dự báo
Những điều R² không trả lời thay cho người phân tích
Mô hình có ổn định trên dữ liệu mới không?
R² được báo cáo dường như là in-sample: mô hình được ước lượng và đánh giá trên cùng dữ liệu. Tài liệu cross-validation của scikit-learn lưu ý rằng học tham số và kiểm tra trên cùng một tập là sai lầm phương pháp khi mục tiêu là dự báo, vì mô hình có thể ghi nhớ mẫu mà không tổng quát hóa.
Bước tiếp theo nên là giữ lại một tập test chưa chạm tới hoặc dùng cross-validation. Nếu dữ liệu có thời gian, nên tách theo thời gian để mô phỏng tình huống dùng quá khứ dự báo tương lai. Khi đó cần báo cáo R² ngoài mẫu cùng MAE hoặc RMSE, không chỉ giữ lại con số đẹp nhất.
Biến có ý nghĩa thống kê nhưng có ý nghĩa kinh doanh không?
F-test p < 0,001 nói rằng toàn bộ mô hình tốt hơn mốc chỉ có hằng số dưới giả định thống kê. P-value của từng hệ số nói về bằng chứng chống giả thuyết hệ số bằng 0 trong đặc tả đó. Cả hai đều không trả lời chi phí triển khai, mức tăng lợi nhuận hay khả năng hành động.
Ví dụ, Beta của Category chỉ khoảng 0,031 dù p < 0,001. Trước khi tạo chiến dịch riêng theo danh mục, cần xem kích thước hiệu ứng theo đơn vị dễ hiểu, biên lợi nhuận, quy mô tệp và kết quả thí nghiệm. “Có ý nghĩa thống kê” và “đáng đầu tư” là hai câu hỏi khác nhau.
Residual, đa cộng tuyến và ngoại lệ có vấn đề không?
Báo cáo có histogram và P–P plot, nhưng hình dạng phần dư vẫn cho thấy độ lệch cần kiểm tra thêm; không nên kết luận các giả định đã hoàn toàn thỏa chỉ bằng một biểu đồ. Bộ kiểm tra nên gồm residual so với fitted values, Q–Q plot, Scale–Location, leverage và Cook’s distance. Tài liệu chẩn đoán hồi quy của statsmodels trình bày chính các nhóm biểu đồ này.
VIF được báo cáo quanh 1 cho các biến trong mô hình, nên chưa cho thấy đa cộng tuyến lớn trong ma trận đã mã hóa. Theo tài liệu VIF của statsmodels, chỉ số này đo mức tăng phương sai ước lượng do quan hệ giữa các biến giải thích. Tuy nhiên, VIF thấp không đảm bảo biến phân loại được mã hóa hợp lý, không phát hiện target leakage và không thay thế kiểm tra outlier.
Nhóm dự án ghi nhận 889 giao dịch đáng chú ý sau khi gộp điều kiện ngoại lệ, nhưng các giá trị vẫn khớp công thức Quantity × Unit Price. Vì vậy, không nên tự động xóa chúng như lỗi dữ liệu; cần xem đó là giao dịch giá trị cao hợp lệ hay điểm có ảnh hưởng quá mạnh đến hệ số.
Có data leakage hoặc đưa thành phần của biến đích vào mô hình không?
Data leakage phụ thuộc vào câu hỏi và thời điểm. Nếu mô hình dự báo Total Amount trước khi khách hoàn tất giỏ hàng, Quantity cuối cùng và Unit Price thực trả có thể là thông tin tương lai; đưa chúng vào sẽ làm đánh giá lạc quan giả tạo. Nếu phân tích sau giao dịch, hai biến không “rò rỉ” theo nghĩa vận hành nhưng khiến hồi quy trở thành phép tái dựng gần như tất định.
Một checklist ngắn trước khi chạy mô hình:
1. Biến này có sẵn tại thời điểm ra quyết định không?
2. Biến này có được tính trực tiếp từ target hoặc target được tính từ nó không?
3. Việc thu thập biến có xảy ra sau kết quả cần dự báo không?
4. Pipeline tiền xử lý có học thông tin từ toàn bộ dữ liệu trước khi chia train/test không?
5. Nếu bỏ biến này, hiệu năng ngoài mẫu và giá trị kinh doanh thay đổi ra sao?
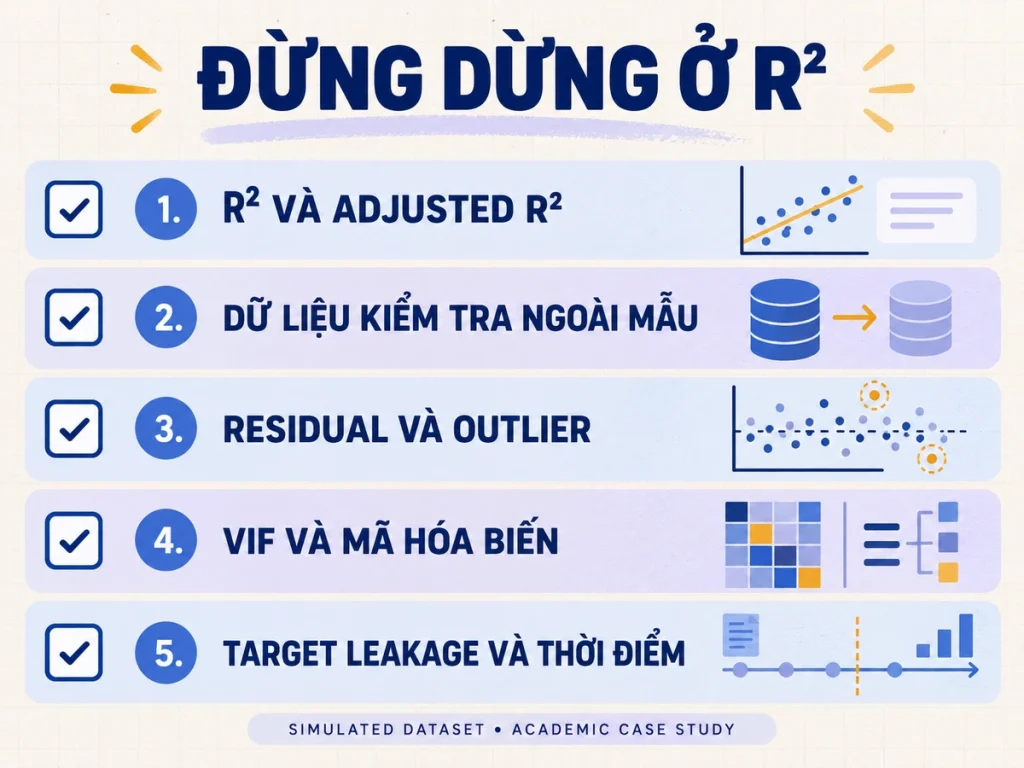
Checklist đánh giá hồi quy gồm dữ liệu ngoài mẫu, residual, VIF, mã hóa và data leakage
Chuyển kết quả hồi quy thành câu hỏi marketing
Danh mục hoặc nhóm giá nào tạo giá trị đơn hàng cao?
Thay vì hỏi “biến nào làm doanh thu tăng”, tôi sẽ chuyển kết quả thành câu hỏi có thể kiểm chứng: nhóm giá nào thường xuất hiện trong giỏ hàng giá trị cao, danh mục nào có khả năng bundle và biên lợi nhuận có đủ để khuyến khích mua kèm hay không?
Cách làm phù hợp là chia price band có lý do kinh doanh, mã hóa Category bằng biến giả, kiểm tra interaction giữa Quantity và nhóm giá, rồi đối chiếu với margin. Kết quả hồi quy chỉ tạo giả thuyết; bundle, price ladder hoặc upsell cần được xác nhận bằng A/B test hay thiết kế quasi-experiment phù hợp.
Phân khúc và thành phố có thật sự giúp dự báo hay không?
Trong đặc tả được báo cáo, Product Name, City và Customer Segment có p-value lần lượt khoảng 0,186; 0,461 và 0,400. Điều đó cho thấy chưa có bằng chứng thống kê rõ cho hệ số của chúng trong cách mã hóa hiện tại. Nó không chứng minh địa lý hoặc phân khúc luôn vô ích.
Có ba khả năng cần tách: biến thật sự đóng góp ít; cách mã hóa đã làm mất cấu trúc; hoặc tác động chỉ xuất hiện qua interaction, mùa vụ hay một target khác. Với biến nhóm, nên one-hot/dummy theo nhóm tham chiếu rõ ràng, gộp mức hiếm hợp lý và đánh giá trên dữ liệu mới.
Cần thử nghiệm dữ liệu nào tiếp theo để hỗ trợ quyết định?
Tôi sẽ tổ chức vòng phân tích tiếp theo theo sáu bước:
1. Chốt mục tiêu và thời điểm dự báo, ví dụ dự báo giá trị giỏ trước khi thanh toán thay vì tính lại tổng tiền sau giao dịch.
2. Tạo baseline đơn giản và tách train/test theo thời gian nếu có timestamp đáng tin.
3. Mã hóa Category, Product Name, City và Segment bằng phương pháp phù hợp; lưu data dictionary và nhóm tham chiếu.
4. So sánh mô hình lồng nhau để báo cáo ΔR², Adjusted R², MAE và RMSE khi thêm từng nhóm biến.
5. Kiểm tra residual, heteroscedasticity, leverage, Cook’s distance, VIF và độ ổn định theo phân khúc.
6. Chuyển insight thành giả thuyết marketing rồi kiểm chứng bằng dữ liệu chiến dịch hoặc A/B test.
Nếu target vẫn là Total Amount và Quantity cùng Unit Price đã biết đầy đủ, mô hình hồi quy không phải công cụ cần thiết. Một target tốt hơn có thể là giá trị giỏ hàng tương lai, xác suất mua lại, khả năng phản hồi ưu đãi hoặc margin kỳ vọng, sử dụng các biến thực sự có sẵn trước quyết định.
Kết luận: Thêm biến có thể làm mô hình giải thích tốt hơn, nhưng diễn giải mới quyết định giá trị
R² tăng từ 22,9% lên 88,7% vì mô hình thứ nhất bỏ sót thông tin giá, trong khi mô hình thứ hai đưa Unit Price và các biến khác vào. Nhưng Total Amount vốn được cấu thành từ Quantity × Unit Price, nên mức tăng mạnh chủ yếu nhắc chúng ta kiểm tra cấu trúc target, không phải ăn mừng một mô hình “chính xác 88,7%”.
Bài học tôi giữ lại sau dự án là luôn hỏi ba câu trước khi nhìn R²: mô hình đang giải thích hay dự báo, biến có sẵn vào lúc nào và kết quả có tạo ra quyết định mới hay chỉ tái dựng một công thức đã biết. Khi trả lời được ba câu đó, R² mới trở thành một phần hữu ích của phân tích marketing.
Xem [ Case study Hasaki Marketing Data Analytics] để xem bối cảnh dự án, dashboard và giới hạn dữ liệu được trình bày đầy đủ.
Nguồn tham khảo
• scikit-learn: Cross-validation và đánh giá dữ liệu chưa thấy
• statsmodels: Variance Inflation Factor
• statsmodels: Linear regression diagnostics
• MathWorks: Linear regression with categorical covariates
• Báo cáo học tập “Báo Cáo Cuối Kỳ G10”, các trang 47–56 và phần kiểm tra ngoại lệ.